


正则表达式用于描述要查找什么样的文本。您指定的是一个模式,而不是某个完全固定的短语:例如“咨询请求”以及它后面的任意编号。每条消息的编号可以不同,模式仍能找到所需片段。
这样可以搜索日期、链接、单个词、整行文本,以及几乎所有能用规则描述的文本组合。几个简单的符号,就能匹配变化的值、从多个选项中选择,并跳过不需要的内容。这种搜索的能力远超普通的按词搜索。
正则表达式的功能
FLOWIN 的过滤器和替换规则支持正则表达式,可用于:
- 在消息开头或结尾添加任意文本。
- 过滤带链接的消息。
- 从复制的消息中删除链接、电话号码、电子邮箱和其他联系信息。
- 过滤长消息,或反过来,只过滤短消息。
如何读懂正则表达式
先来看模式咨询请求 №\d+。它既能找到咨询请求 №125,也能找到咨询请求 №8072,尽管编号不同。让我们从左往右读:
咨询请求 №查找的正是这些文字、空格和编号符号。\d表示 0 到 9 中的任意一个数字。+要求连续出现一个或多个这样的数字。
找到的片段称为匹配结果。在消息咨询请求 №125 已受理中,匹配结果是咨询请求 №125,而已受理一词不包含在内。在过滤器中,匹配结果有助于判断消息是否符合条件;在替换规则中,它指出要修改哪个片段。
模式中的普通文字和空格会按原样搜索。特殊符号则用于设定规则。下面先介绍基本符号,然后列出适用于不同任务的现成示例。
正则表达式语法
要开始使用正则表达式,需要了解其语法,也就是理解特定符号的含义。
基本符号
^表示文本开头。$表示文本结尾。.匹配任意字符,包括换行符。\d匹配 0 到 9 中的一个数字。\w匹配一个拉丁字母、数字或下划线。\n表示换行。\t表示制表符。\s匹配普通空格、制表符、换行符、回车符或换页符。\b检查单词边界,例如字母和空格之间的位置。它本身不会向匹配结果中添加字符。
量词
量词指定它前面的字符或组重复多少次。组用圆括号将多个字符组合起来。
*表示零次或多次。+表示一次或多次。?表示零次或一次。{5}表示恰好 5 次。{1,5}表示 1 至 5 次。{1,}表示一次或多次。{0,5}表示 0 至 5 次。
例如:
a+可以匹配a、aa、aaa等。.*可以匹配任意文本,甚至是空文本。аб{3}可以匹配аббб。
组
圆括号 ( ) 可将字符组合成组。组最常与量词或竖线 | 搭配使用,竖线表示逻辑“或”。
例如:
((Bob)|(Alice))既可以匹配Bob,也可以匹配Alice。(abc){3}可以匹配abcabcabc。
字符集合
字符集合使用方括号 [ ] 表示。可以像下面这样在其中列出字符:
[а-яё]匹配任意一个俄文字母。[абвгд]或[а-д]匹配а、б、в、г或д中的任意一个字母。[a-z]匹配从a到z的任意一个拉丁字母。[0-5]匹配 0 到 5 中的任意一个数字。
符号 ^ 在集合开头表示逻辑“非”:
[^а-яё]匹配除俄文字母以外的任意字符。[^a-z]匹配除a到z范围内的拉丁字母以外的任意字符。[^\s]匹配不属于\s的任意字符。
在 FLOWIN 中, \w 不包含西里尔字母。 [а-яё] 涵盖俄文字母表,包括 ё。而 [а-я] 范围不包含这个字母。
字符转义
如果要将功能性符号作为普通文本使用,而不是作为语法的一部分,就需要在它前面加反斜杠 \。这称为转义。
例如:
:\)可以匹配:)。这里的括号表示普通括号,而不是组。谁\?可以匹配谁?。这里的问号不表示重复次数。
FLOWIN 中的搜索设置
标志会改变搜索的通用规则,例如是否区分大小写。FLOWIN 已启用部分设置,因此同一个模式的行为,可能与使用默认设置的第三方测试工具不同。
标志已配置好
过滤器和替换规则已启用 IgnoreCase (i)、 Singleline (s)、 RE2 和 Unicode。无需手动为每个模式添加这些标志。实际使用时,需要注意以下几点:
i使搜索不区分大小写:кот既能找到Кот,也能找到КОТ。s允许点号.匹配换行。因此,.*可能一次匹配多行。- 多行模式
Multiline (m)默认关闭:^和$表示整条消息的开头和结尾,而非每一行的开头和结尾。 RE2决定了语法的特性:\d查找数字 0–9,而\w只查找拉丁字母、数字和下划线。启用Unicode也不会使\w包含西里尔字母。
使用下面的现成示例不需要切换任何设置。如果在其他服务中测试,请考虑这些设置:即使标志名称相同,也不能保证不同引擎的行为一致。
现成模板
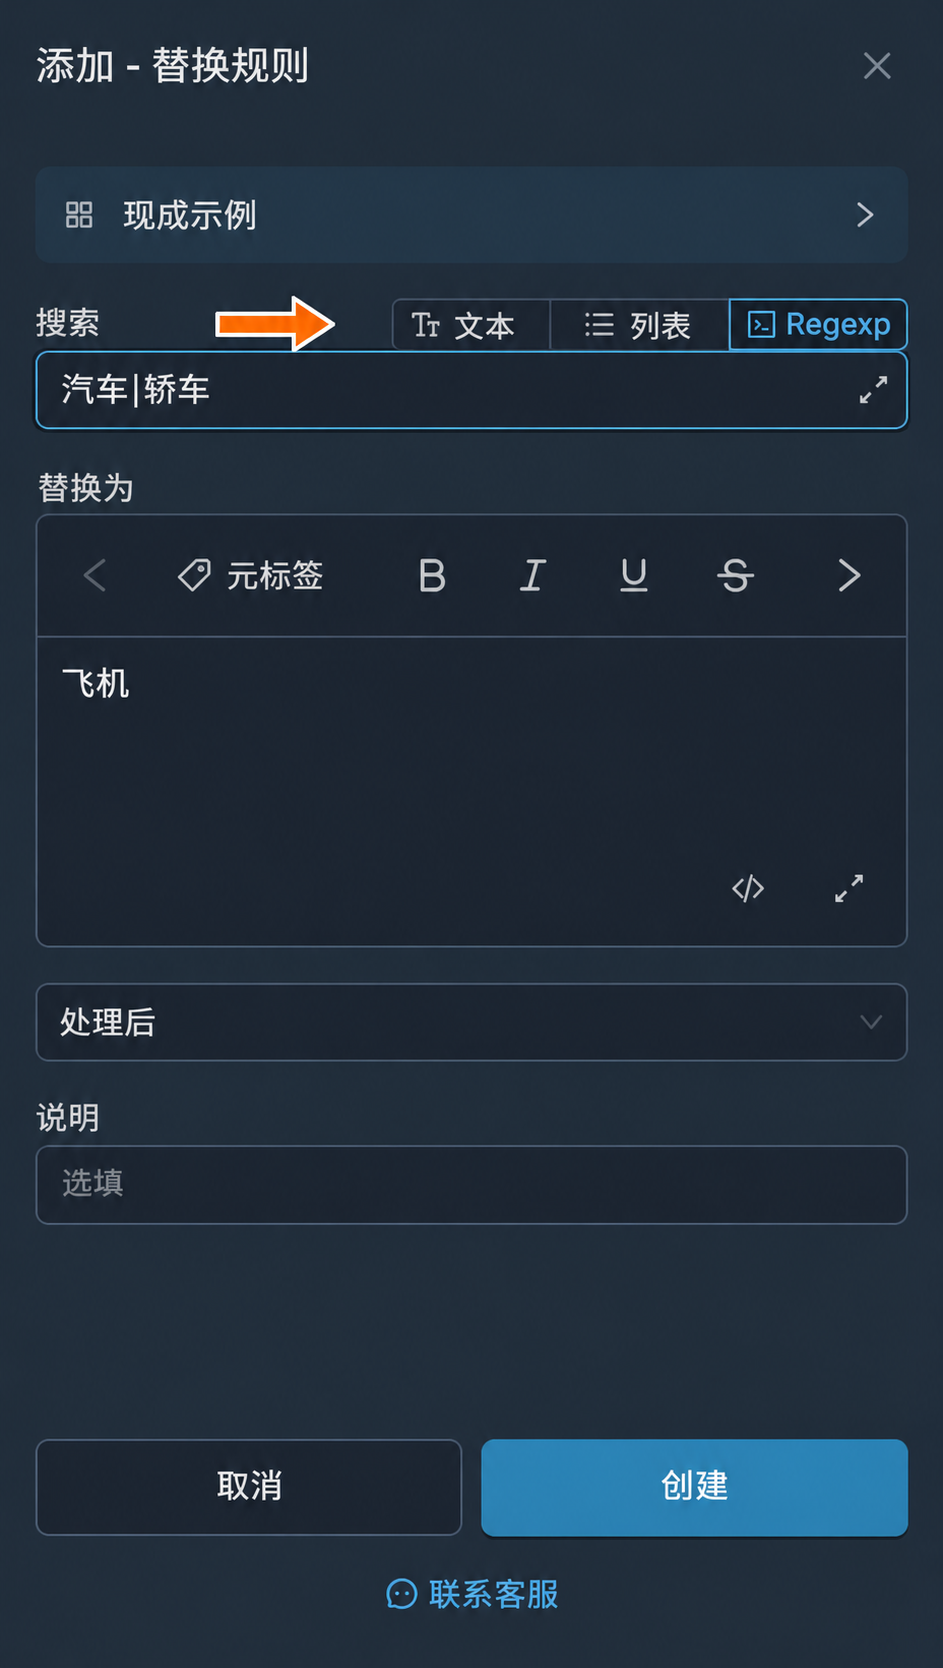
选择任务,将模式复制到已选择“Regexp”模式的“搜索”字段中。示例显示的是实际找到的文本。之后消息会发生什么,取决于设置的过滤器或替换规则。
每次都不同的咨询请求编号
在事先不知道编号的情况下查找咨询请求。
模式:咨询请求 №\d+
文本:咨询请求 №125 已受理。咨询请求 №8072 等待回复。
找到:咨询请求 №125、咨询请求 №8072。
“咨询请求 №”这部分文本保持不变, \d+ 会查找连续的一个或多个数字。№ 前的空格也属于模式的一部分。“咨询请求 №ABC”不会匹配。
仅包含六位数字的消息
筛选恰好包含一个六位数代码的消息。
模式:^\d{6}$
文本: 482901
找到: 482901。
开头和结尾将范围限定为整条消息,而 {6} 规定了六位数字。“代码: 482901”“48290”以及末尾带空格的“482901 ”都不会匹配。
多个文本选项之一
查找提及两个状态之一的消息。
模式:完成|取消
文本:完成:文件已发送。另一项任务已取消。
找到:完成、取消。
竖线表示“或”。字母大小写不影响匹配。没有单词边界时,模式也会在“已完成的”内部找到“完成”。
完整单词,不匹配其他词内部的文本
查找“кот”一词,跳过“котёнок”和“скот”。
模式:\bкот\b
文本: Кот, котёнок и скот.
找到: Кот。
\b 检查单词两侧的边界。空格和标点可以将单词与相邻文本分隔开;它们本身不属于匹配结果。
日.月.年格式的日期
查找日和月各用两位数字、年用四位数字表示的日期。
模式:\d{2}\.\d{2}\.\d{4}
文本:会议 16.10.2026,12:00。
找到: 16.10.2026。
\. 表示普通点号,而不是任意字符。模式检查的是书写形式,而非日历日期:“99.99.2026”也会匹配。
俄语和英语话题标签
查找由字母、数字和下划线组成的话题标签。
模式:#[а-яёa-z0-9_]+
文本: #Новости #release_2 #всё_готово
找到: #Новости、 #release_2、 #всё_готово。
# 后面是集合中的一个或多个字符。空格或连字符会结束匹配:在“#план-дня”中,只会找到“#план”。
@username 形式的提及
查找类似用户或频道提及的文本。
模式:@[a-z0-9_]{3,}
文本:作者: @news_room。另一个: @ab。
找到: @news_room。
@ 后面至少需要三个拉丁字母、数字或下划线。模式查找的是书写形式,并不验证用户是否存在。它也可能匹配到电子邮件地址的一部分。
以 http:// 或 https:// 开头的链接
查找明确写出协议的网址。
模式:https?:\/\/[^\s]+
文本:打开 https://example.org/page 和 http://example.org
找到: https://example.org/page、 http://example.org。
字母 s 可以省略。在 // 后,模式会一直获取字符,直到遇到最近的空格或 \s 中的其他分隔符。不带协议的地址不会匹配,紧贴地址的逗号或句号则可能被包含在匹配结果中。
+7 后接十位数字的电话号码
查找连续书写、不含括号、空格和连字符的电话号码。
模式:\+7\d{10}
文本:联系号码: +79991234567
找到: +79991234567。
\+ 查找普通加号,而 \d{10} 规定 7 后面恰好跟十位数字。“+7 (999) 123-45-67”这种形式不会匹配。这是按书写形式搜索,并不验证号码是否存在;在更长的数字串内部也可能产生匹配。
以指定标记开头的消息
只在消息最开头查找“重要:”标记。
模式:^重要:
文本:重要: 会议已改期。
找到:重要:。
^ 检查整段文本的开头。“更新: 重要: 会议已改期”中不会有匹配结果。第二行开头的标记也不会匹配,因为多行模式默认关闭。
词与词之间多余的空格
查找连续的两个或更多普通空格,以便随后将它们替换为一个空格。
模式:[ ]{2,}
在文本带有··多余···空格的文本中会找到两组空格:两个空格和三个空格。这里的 · 符号只用于表示普通空格,不需要输入。
方括号内是一个普通空格,而 {2,} 要求至少连续出现两个。要去掉多余空格,可将找到的片段替换为一个空格。此模式不会影响换行。
不超过一百个字符的短消息
筛选长度为 1 至 100 个字符的非空消息。
模式:^.{1,100}$
文本:简短消息
找到:简短消息。
点号会计入任意字符,包括空格和换行。括号设定数量范围,而 ^ 和 $ 要求检查整条消息。空消息和超过 100 个字符的文本都不会匹配。一个组合表情符号可能被计为多个字符。
此列表会不断补充。如有新模板的建议,可以发送给客服 @value_maker。
测试自己的模式
在 regex101.com 上可以方便地测试自己的正则表达式。该网站的搜索设置可能与 FLOWIN 不同,因此在应用到正式转发任务前,需要先用测试消息验证:既测试应当匹配的消息,也测试不应当匹配的消息。
常见问题
什么时候“文本”或“列表”就够了,什么时候需要“Regexp”?
“文本”模式适用于一个已知短语,“列表”则可以列出多个选项。当文本按某种规则变化时,就需要“Regexp”:例如“咨询请求”后每次都有一个新的编号。它还有助于设定单词边界或字符数量。对找到的消息执行什么操作,需要在过滤器或替换规则中单独设置。
为什么在线测试工具中的表达式在 FLOWIN 中表现不同?
结果取决于引擎和搜索设置。FLOWIN 的过滤器和替换规则已启用 IgnoreCase、Singleline、RE2 和 Unicode,而 Multiline 默认关闭。因此,搜索不区分大小写,点号可以匹配换行,而 ^ 和 $ 表示整条消息的边界。请核对搜索设置,并在 FLOWIN 中用应当匹配和不应当匹配的消息测试表达式。
为什么 .* 会匹配多行?
FLOWIN 启用了 Singleline:点号也可以匹配换行。因此, .* 不一定会停在第一行末尾。如果要查找下一个换行符之前的文本,可以使用 [^\r\n]+:该模式查找除回车和换行以外的一个或多个字符。
为什么 \w 找不到俄文字母?
在 FLOWIN 的搜索设置中, \w 涵盖拉丁字母、数字和下划线。要匹配俄文字母,请使用 [а-яё];要匹配这些字母组成的序列,请使用 [а-яё]+。字母 ё 需要单独列出: а-я 范围不包含它。由于搜索已经不区分大小写,无需区分大写和小写字母。
如何查找完整单词,而不匹配其他词内部的文本?
在单词两侧添加 \b。例如, \bкот\b 会在“Кот, котёнок и скот”中找到“Кот”,但跳过另外两个词。边界检查的是单词的位置,空格和标点不会被包含在找到的片段中。
示例中的日期模式会检查该日期是否存在吗?
不会。表达式 \d{2}\.\d{2}\.\d{4} 只检查书写形式:两位数字、点号、两位数字、点号和四位数字。因此,它既能找到 16.10.2026,也能找到 99.99.2026。此示例适用于查找类似日期的片段,但不能确认日和月是否有效。
如果正则表达式什么也找不到,需要检查什么?
首先确认“搜索”字段旁已选择“Regexp”。然后将模式与原始文本进行比较:空格、换行和普通符号也会影响匹配。例如,咨询请求 №\d+ 要求 № 前有空格,后面有数字,因此不会找到咨询请求№125 或咨询请求 №ABC。还要检查边界 ^ 和 $:默认情况下,它们表示整条消息的边界。先从简单的片段开始,逐个添加条件,每次都检查结果。