

Регулярное выражение описывает, какой текст нужно найти. Вместо одной точной фразы вы задаёте шаблон: например, слово «Заявка» и любой номер после него. Номер может меняться в каждом сообщении, а шаблон всё равно найдёт нужный фрагмент.
Так можно искать даты, ссылки, отдельные слова, целые строки и почти любые сочетания текста, которые можно описать правилом. Несколько простых символов позволяют учитывать меняющиеся значения, выбирать из разных вариантов и пропускать ненужное. Возможности такого поиска гораздо шире обычного поиска по слову.
Возможности регулярных выражений
Поддержка регулярных выражений в фильтрах и заменах FLOWIN позволяет:
- Добавлять в начало или в конец сообщений любой текст.
- Фильтровать сообщения со ссылками.
- Удалять ссылки, телефоны, почту и прочую контактную информацию из копируемых сообщений.
- Фильтровать длинные сообщения или, наоборот, только короткие.
Как читать регулярное выражение
Начнём с шаблона Заявка №\d+. Он находит и Заявка №125, и Заявка №8072, хотя номера разные. Прочитаем его слева направо:
Заявка №ищет именно эти буквы, пробел и знак номера.\dобозначает любую цифру от 0 до 9.+требует одну или несколько таких цифр подряд.
Найденный фрагмент называют совпадением. В сообщении Заявка №125 принята совпадением будет Заявка №125, а слово принята останется за его пределами. В фильтре совпадение помогает определить, подходит ли сообщение под условие; в замене оно указывает, какой фрагмент изменить.
Обычные буквы и пробелы в шаблоне ищутся как написаны. Специальные символы задают правила. Ниже разобраны основные обозначения, а затем собраны готовые примеры для разных задач.
Синтаксис регулярок
Чтобы начать использовать регулярные выражения, нужно знать синтаксис, то есть понимать, что обозначают определённые символы.
Основные символы
^обозначает начало текста.$обозначает конец текста..соответствует любому символу, включая перенос строки.\dсоответствует цифре от 0 до 9.\wсоответствует латинской букве, цифре или знаку подчёркивания.\nобозначает перенос строки.\tобозначает табуляцию.\sсоответствует обычному пробелу, табуляции, переносу строки, возврату каретки или переводу страницы.\bпроверяет границу слова, например между буквой и пробелом. Сам символ в совпадение не добавляет.
Количественные символы
Количественные символы указывают, сколько раз повторяется символ или группа перед ними. Группа объединяет несколько символов в круглых скобках.
*означает 0 и более раз.+означает 1 и более раз.?означает 0 или 1 раз.{5}означает ровно 5 раз.{1,5}означает от 1 до 5 раз.{1,}означает 1 и более раз.{0,5}означает от 0 до 5 раз.
Например:
a+соответствуетa,aa,aaaи так далее..*соответствует любому тексту, даже пустому.аб{3}соответствуетаббб.
Группы
Круглые скобки ( ) объединяют символы в группу. Группы чаще всего используют с количественными символами или с вертикальной чертой |, которая обозначает логическое ИЛИ.
Например:
((Bob)|(Alice))соответствует какBob, так иAlice.(abc){3}соответствуетabcabcabc.
Набор символов
Для указания набора символов используются квадратные скобки [ ]. Внутри них символы можно перечислить так:
[а-яё]соответствует любой букве русского алфавита.[абвгд]или[а-д]соответствует одной из буква,б,в,гилид.[a-z]соответствует любой букве латиницы отaдоz.[0-5]соответствует любой цифре от 0 до 5.
Символ ^ в начале набора обозначает логическое НЕ:
[^а-яё]соответствует любому символу, кроме буквы русского алфавита.[^a-z]соответствует любому символу, кроме буквы латиницы отaдоz.[^\s]соответствует любому символу, который не входит в\s.
В FLOWIN \w не включает кириллицу. [а-яё] охватывает русский алфавит, включая ё. В диапазон [а-я] эта буква не входит.
Экранирование символов
Если служебный символ нужен как обычный текст, а не как часть синтаксиса, перед ним ставится обратный слеш \. Это называется экранированием.
Например:
:\)соответствует:). Скобка здесь обозначает обычную скобку, а не группу.кто\?соответствуеткто?. Знак вопроса здесь не задаёт количество повторений.
Настройки поиска в FLOWIN
Флаги меняют общие правила поиска: например, нужно ли различать большие и маленькие буквы. В FLOWIN часть настроек уже включена, поэтому один и тот же шаблон может вести себя иначе, чем в стороннем тестере с настройками по умолчанию.
Флаги уже настроены
В фильтрах и заменах включены IgnoreCase (i), Singleline (s), RE2 и Unicode. Добавлять их вручную к каждому шаблону не нужно. Вот что важно на практике:
iотключает различие регистра:котнайдёт иКот, иКОТ.sразрешает точке.находить перенос строки. Поэтому.*может захватить несколько строк сразу.- Многострочный режим
Multiline (m)по умолчанию выключен:^и$относятся к началу и концу всего сообщения, а не каждой строки. RE2задаёт особенности синтаксиса:\dищет цифры 0–9, а\wтолько латинские буквы, цифры и подчёркивание. ВключённыйUnicodeне добавляет кириллицу в\w.
Для готовых примеров ниже ничего переключать не требуется. Если проверяете их в другом сервисе, учитывайте эти настройки: совпадение названий флагов ещё не гарантирует одинаковое поведение разных движков.
Готовые шаблоны
Выберите задачу и скопируйте шаблон в поле «Искать» с режимом «Regexp». В примерах показан именно найденный текст. Что затем произойдёт с сообщением, зависит от настроенного фильтра или замены.
Номер заявки, который каждый раз меняется
Найти заявку, не зная её номера заранее.
Шаблон:Заявка №\d+
Текст: Заявка №125 принята. Заявка №8072 ожидает ответа.
Найдёт: Заявка №125, Заявка №8072.
Текст «Заявка №» остаётся постоянным, а \d+ находит одну или несколько цифр подряд. Пробел перед № тоже входит в шаблон. «Заявка №ABC» не подойдёт.
Сообщение только из шести цифр
Отобрать сообщения, в которых находится ровно шестизначный код.
Шаблон:^\d{6}$
Текст: 482901
Найдёт: 482901.
Начало и конец ограничивают всё сообщение, а {6} задаёт шесть цифр. «Код: 482901», «48290» и «482901 » с пробелом в конце не подойдут.
Один из нескольких вариантов текста
Найти сообщения с упоминанием одного из двух статусов.
Шаблон:готово|отменено
Текст: Готово: файл отправлен. Другое задание отменено.
Найдёт: Готово, отменено.
Вертикальная черта означает «или». Регистр букв не важен. Без границ слова шаблон найдёт «готово» и внутри слова «готового».
Слово целиком, без совпадений внутри других слов
Найти слово «кот», пропуская «котёнок» и «скот».
Шаблон:\bкот\b
Текст: Кот, котёнок и скот.
Найдёт: Кот.
\b по обе стороны проверяет границы слова. Пробелы и пунктуация могут отделять слово от соседнего текста; сами они в совпадение не входят.
Дата в формате день.месяц.год
Найти дату, у которой день и месяц записаны двумя цифрами, а год четырьмя.
Шаблон:\d{2}\.\d{2}\.\d{4}
Текст: Встреча 16.10.2026 в 12:00.
Найдёт: 16.10.2026.
\. обозначает обычную точку, а не любой символ. Шаблон проверяет форму записи, но не календарь: «99.99.2026» тоже совпадёт.
Хештеги на русском и английском
Найти хештеги из букв, цифр и знаков подчёркивания.
Шаблон:#[а-яёa-z0-9_]+
Текст: #Новости #release_2 #всё_готово
Найдёт: #Новости, #release_2, #всё_готово.
После # идёт один или несколько символов из набора. Пробел или дефис завершит совпадение: в «#план-дня» будет найдено только «#план».
Упоминания вида @username
Найти текст, похожий на упоминание пользователя или канала.
Шаблон:@[a-z0-9_]{3,}
Текст: Автор: @news_room. Ещё один: @ab.
Найдёт: @news_room.
После @ нужны хотя бы три буквы латиницы, цифры или знака подчёркивания. Шаблон ищет форму записи, а не проверяет существование пользователя. Он также может найти часть адреса электронной почты.
Ссылки с http:// или https://
Найти явно записанный веб-адрес с протоколом.
Шаблон:https?:\/\/[^\s]+
Текст: Откройте https://example.org/page и http://example.org
Найдёт: https://example.org/page, http://example.org.
Буква s необязательна. После // шаблон забирает символы до ближайшего пробела или другого разделителя из \s. Адрес без протокола не подойдёт, а запятая или точка вплотную к адресу могут попасть в совпадение.
Телефон в записи +7 и десять цифр
Найти номер, записанный слитно, без скобок, пробелов и дефисов.
Шаблон:\+7\d{10}
Текст: Контакт: +79991234567
Найдёт: +79991234567.
\+ ищет обычный плюс, а \d{10} задаёт ровно десять следующих за 7 цифр. Вариант «+7 (999) 123-45-67» не совпадёт. Это поиск по форме записи, не проверка существования номера; внутри более длинной цепочки цифр тоже возможно совпадение.
Сообщения, которые начинаются с нужной пометки
Найти пометку «Важно:» только в самом начале сообщения.
Шаблон:^Важно:
Текст: ВАЖНО: встреча перенесена.
Найдёт: ВАЖНО:.
^ проверяет начало всего текста. В «Обновление: Важно: встреча перенесена» совпадения не будет. Пометка в начале второй строки тоже не подойдёт, поскольку многострочный режим по умолчанию выключен.
Лишние пробелы между словами
Найти два или больше обычных пробела подряд, чтобы затем заменить их одним.
Шаблон:[ ]{2,}
В тексте Текст··с···пробелами будут найдены две группы: два и три пробела. Знак · здесь только показывает обычный пробел; вводить его не нужно.
Внутри квадратных скобок стоит обычный пробел, а {2,} требует хотя бы два подряд. Чтобы убрать лишние пробелы, найденные фрагменты заменяют одним пробелом. Переносы строк такой шаблон не затрагивает.
Короткие сообщения до ста символов
Отобрать непустые сообщения длиной от 1 до 100 символов.
Шаблон:^.{1,100}$
Текст: Короткое сообщение
Найдёт: Короткое сообщение.
Точка считает любые символы, в том числе пробелы и переносы строк. Скобки задают пределы, а ^ и $ требуют проверить сообщение целиком. Пустое сообщение и текст длиннее 100 символов не подойдут. Составной эмодзи может считаться несколькими символами.
Список будет пополняться. Предложения новых шаблонов можно отправить в поддержку @value_maker.
Проверка своего шаблона
На regex101.com удобно проверять собственные регулярные выражения. Настройки поиска там могут отличаться от FLOWIN, поэтому перед применением к рабочей пересылке нужна проверка на тестовых сообщениях: с ожидаемым совпадением и без него.
Частые вопросы
Когда достаточно «Текст» или «Список», а когда нужен «Regexp»?
Режим «Текст» подходит для одной известной фразы, а «Список» позволяет перечислить несколько вариантов. «Regexp» нужен, когда текст меняется по правилу: например, после слова «Заявка» каждый раз стоит новый номер. Он также помогает задать границы слова или количество символов. Действие с найденным сообщением настраивается отдельно в фильтре или замене.
Почему выражение из онлайн-тестера работает в FLOWIN иначе?
Результат зависит от движка и настроек поиска. В фильтрах и заменах FLOWIN уже включены IgnoreCase, Singleline, RE2 и Unicode, а Multiline по умолчанию выключен. Поэтому регистр букв не различается, точка может найти перенос строки, а ^ и $ относятся ко всему сообщению. Сверьте настройки поиска и проверьте выражение в FLOWIN на сообщениях с ожидаемым совпадением и без него.
Почему .* захватывает несколько строк?
В FLOWIN включён Singleline: точка соответствует и переносу строки. Поэтому .* не обязано останавливаться в конце первой строки. Если нужно найти текст до ближайшего переноса, можно использовать [^\r\n]+: этот шаблон ищет один или несколько символов, кроме возврата каретки и переноса строки.
Почему \w не находит русские буквы?
В настройках поиска FLOWIN \w охватывает латинские буквы, цифры и подчёркивание. Для русских букв используйте [а-яё], а для последовательности таких букв [а-яё]+. Букву ё нужно указывать отдельно: диапазон а-я её не включает. Большие и маленькие буквы различать не требуется, поскольку поиск уже не учитывает регистр.
Как найти слово целиком, а не внутри другого слова?
Добавьте \b с обеих сторон слова. Например, \bкот\b найдёт «Кот» в тексте «Кот, котёнок и скот», но пропустит два других слова. Границы проверяют положение слова, а пробелы и знаки препинания в найденный фрагмент не входят.
Шаблон даты из примера проверяет, существует ли такая дата?
Нет. Выражение \d{2}\.\d{2}\.\d{4} проверяет только форму записи: две цифры, точка, две цифры, точка и четыре цифры. Поэтому оно найдёт и 16.10.2026, и 99.99.2026. Этот пример подходит для поиска похожих на дату фрагментов, но не подтверждает правильность дня и месяца.
Что проверить, если регулярное выражение ничего не находит?
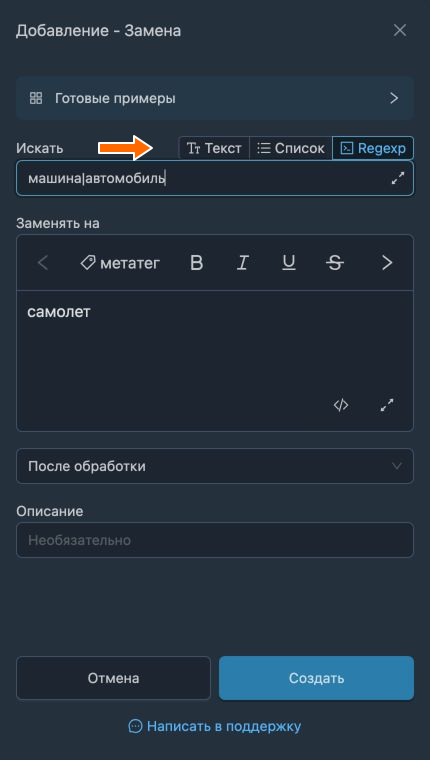
Сначала убедитесь, что рядом с полем «Искать» выбран «Regexp». Затем сравните шаблон с исходным текстом: пробелы, переносы строк и обычные знаки тоже влияют на совпадение. Например, Заявка №\d+ требует пробел перед № и цифры после него, поэтому не найдёт Заявка№125 или Заявка №ABC. Проверьте также границы ^ и $: по умолчанию они относятся ко всему сообщению. Начните с простого фрагмента и добавляйте условия по одному, каждый раз проверяя результат.